Ist es definitiv. Wenn man weiß, wieso etwas nicht funktioniert, dann kann man es versuchen zu reparieren und das wird auch geschehen. KI nervt und ich hasse es, aber ich glaube, wir müssen uns damit leider abfinden.
Kommt drauf an ob prinzipbedingtes Problem ist oder nicht, bei ersteren kann man nur versuchen die "KI" zu überreden nicht die Antworten zu geben die man nicht haben will ("don't talk about goblins") oder für Einzelfälle die richtige Antwort vorgeben (jede virale falsche Antwort wie "how many r in strawberry" die dann richtig beantwortet wird, aber keine generelle Lösung für andere Fragen der gleichen Klasse bietet).
oder für Einzelfälle die richtige Antwort vorgeben (jede virale falsche Antwort wie "how many r in strawberry" die dann richtig beantwortet wird, aber keine generelle Lösung für andere Fragen der gleichen Klasse bietet).
Ne, da hast du ein schlechtes Beispiel gewählt, denn das Problem taucht nur bei "gewöhnlichen" LLMs auf, nicht bei reasoning Modellen. Für das Beispiel muss man also nicht für den Einzelfall die Lösung vorgeben, reasoning Modelle haben mit der Frage keine Probleme
Auch OPs Beispiel wird nur von gewöhnlichen LLMs falsch beantwortet, reasoning Modelle beantworten die Frage richtig:
Nein nein, du hast es nur falsch verwendet! Wenn du fünf weitere LLMs mit folgendem Satz als Workflow einstellst, sinkt die Chance eines Fehlers um 2%!
Wie Artikel von Effizienz sprechen, ist mir schleierhaft. Du brauchst ein ganzes Team der Bullshitmaschinerie in der Hoffnung, einer davon produziert Shakespeare.
LLMs arbeiten nicht mit Buchstaben, sondern mit Tokens. Theoretisch könnte man Token=Buchstabe definieren, das wäre aber sehr ineffizient, daher macht man das nicht. Praktisch sind Tokens eher Silben oder Wortteile, also zb „Donners““Tag“ wären dann zwei Tokens. Jeder Token wird durch eine Zahl repräsentiert und dann wird wild gerechnet.
Aber wegen der Tokengeschichte kann man da rechnen wie man will, die Buchstaben kennt das LLM nicht und kann daher damit auch nicht wirklich arbeiten. Daher wird halt ein plausibler Text generiert der halt in diesem Fall nichts mit der korrekten Antwort zu tun hat.
Was LLMs ausgeben ist nicht die Antwort auf die Frage "Welche Wochentage haben den Buchstaben T?" sondern "Wie könnte eine Antwort auf die Frage 'Welche Wochentage haben den Buchstaben T?' aussehen?"
Man kann dann noch Details rumerklären wie dass die mit Tokens arbeiten und keine Wörter oder Buchstaben kennen, aber das grundsätzliche Problem ist dass hinter der Ausgabe keine echte Intelligenz steckt, sondern Statistik¹ beruhend auf dem Trainingsmaterial die durch kompetent wirkende Sprachproduktion intelligent wirkt.
¹ Sehr komplexe Statistik, und mehr Ebenen von Komplexität drüber die versuchen die offensichtlichen Probleme zu kaschieren.

29 Comments
aaaaaaaaargh@feddit.org · 45 pts · 108d
Hab es auch ausprobiert und es wurde Kunst.
FUsername@feddit.org · 6 pts · 106d
Stabil bescheiden formuliert!
DmMacniel@feddit.org · 26 pts · 108d
Tja Schachmatt liebe Konservativen, euer Maschinengott hat ja zur 4 Tage Woche gesagt!
rbn@sopuli.xyz · 2 pts · 108d
Aber leider nur 3 einzelne freie Tage. Weniger zersplittert wäre mir lieber.
A_norny_mousse@piefed.zip · 17 pts · 108d
😁
Und dann kommen immer wieder Leute die uns erklären warum LLMs Schwierigkeiten mit sowas haben, als wenn das dadurch besser würde.
aaaaaaaaargh@feddit.org · 7 pts · 108d
Ist es definitiv. Wenn man weiß, wieso etwas nicht funktioniert, dann kann man es versuchen zu reparieren und das wird auch geschehen. KI nervt und ich hasse es, aber ich glaube, wir müssen uns damit leider abfinden.
SkavarSharraddas@gehirneimer.de · 5 pts · 108d
Kommt drauf an ob prinzipbedingtes Problem ist oder nicht, bei ersteren kann man nur versuchen die "KI" zu überreden nicht die Antworten zu geben die man nicht haben will ("don't talk about goblins") oder für Einzelfälle die richtige Antwort vorgeben (jede virale falsche Antwort wie "how many r in strawberry" die dann richtig beantwortet wird, aber keine generelle Lösung für andere Fragen der gleichen Klasse bietet).
A_norny_mousse@piefed.zip · 2 pts · 107d
🔔🔔🔔
Anivia@feddit.org · 1 pts · 107d
Ne, da hast du ein schlechtes Beispiel gewählt, denn das Problem taucht nur bei "gewöhnlichen" LLMs auf, nicht bei reasoning Modellen. Für das Beispiel muss man also nicht für den Einzelfall die Lösung vorgeben, reasoning Modelle haben mit der Frage keine Probleme
Auch OPs Beispiel wird nur von gewöhnlichen LLMs falsch beantwortet, reasoning Modelle beantworten die Frage richtig:
FUsername@feddit.org · 2 pts · 106d
Na toll, ein Klugscheißer-LLM!
Randelung@lemmy.world · 3 pts · 108d
Nein nein, du hast es nur falsch verwendet! Wenn du fünf weitere LLMs mit folgendem Satz als Workflow einstellst, sinkt die Chance eines Fehlers um 2%!
Wie Artikel von Effizienz sprechen, ist mir schleierhaft. Du brauchst ein ganzes Team der Bullshitmaschinerie in der Hoffnung, einer davon produziert Shakespeare.
fizzgig@feddit.org · 2 pts · 108d
Jetzt will ich wissen, weshalb die damit Probleme haben! :D
jgjl@discuss.tchncs.de · 5 pts · 108d
LLMs arbeiten nicht mit Buchstaben, sondern mit Tokens. Theoretisch könnte man Token=Buchstabe definieren, das wäre aber sehr ineffizient, daher macht man das nicht. Praktisch sind Tokens eher Silben oder Wortteile, also zb „Donners““Tag“ wären dann zwei Tokens. Jeder Token wird durch eine Zahl repräsentiert und dann wird wild gerechnet. Aber wegen der Tokengeschichte kann man da rechnen wie man will, die Buchstaben kennt das LLM nicht und kann daher damit auch nicht wirklich arbeiten. Daher wird halt ein plausibler Text generiert der halt in diesem Fall nichts mit der korrekten Antwort zu tun hat.
SkavarSharraddas@gehirneimer.de · 4 pts · 108d
Was LLMs ausgeben ist nicht die Antwort auf die Frage "Welche Wochentage haben den Buchstaben T?" sondern "Wie könnte eine Antwort auf die Frage 'Welche Wochentage haben den Buchstaben T?' aussehen?"
Man kann dann noch Details rumerklären wie dass die mit Tokens arbeiten und keine Wörter oder Buchstaben kennen, aber das grundsätzliche Problem ist dass hinter der Ausgabe keine echte Intelligenz steckt, sondern Statistik¹ beruhend auf dem Trainingsmaterial die durch kompetent wirkende Sprachproduktion intelligent wirkt.
¹ Sehr komplexe Statistik, und mehr Ebenen von Komplexität drüber die versuchen die offensichtlichen Probleme zu kaschieren.
Randelung@lemmy.world · 1 pts · 108d
viertesauge@feddit.org · 17 pts · 108d
Aber wie viele H's hat Habicht?
dangrousperson@feddit.org · 16 pts · 108d
Offensichtlich hat Dienstag zwei t's und nur Mittwoch hat keine
edit: liegt wahrscheinlich daran, dass er einen Facebook Post als 'Quelle' gefunden hat wo es Middwoch heißt
KraeuterRoy@feddit.org · 4 pts · 108d
Na wenn es in einer x-beliebigen Pfostierung auf Fratzenbuch steht, muss es ja stimmen!
Eines muss Mann dem Klapperer lassen: die Quellenauswahl ist nicht zu beanstanden.
jgjl@discuss.tchncs.de · 16 pts · 108d
Also Le Mistral Vibe ist direkt gestorben:
jokro@feddit.org · 3 pts · 108d
Bei mir auch, aber auch bei anderen Fragen, scheint gerade kaputt
ennof@feddit.org · 2 pts · 107d
Ja, Le Chat (Vibe) is grade kaputt.
jgjl@discuss.tchncs.de · 1 pts · 107d
Bei mir geht’s wieder und gibt sogar die richtige Antwort :)
KraeuterRoy@feddit.org · 7 pts · 108d
Kein Wunder, dass es so ein schlechtes Ergebnis gibt. Du hast vergessen "Bitte nicht halluzinieren!" in den Prompt zu schreiben!
Einmal mehr sitzt das Problem vor dem Bildschirm!1elf
Kornclown@feddit.org · 6 pts · 108d
(͡•_ ͡• )
stardustpathsofglory@lemmy.world · 3 pts · 107d
Gute Antwort! Welches Model hast du da verwendet?
curlywurly@piefed.social · 5 pts · 106d
Ach Mensch, was für ein klassischer Denkfehler!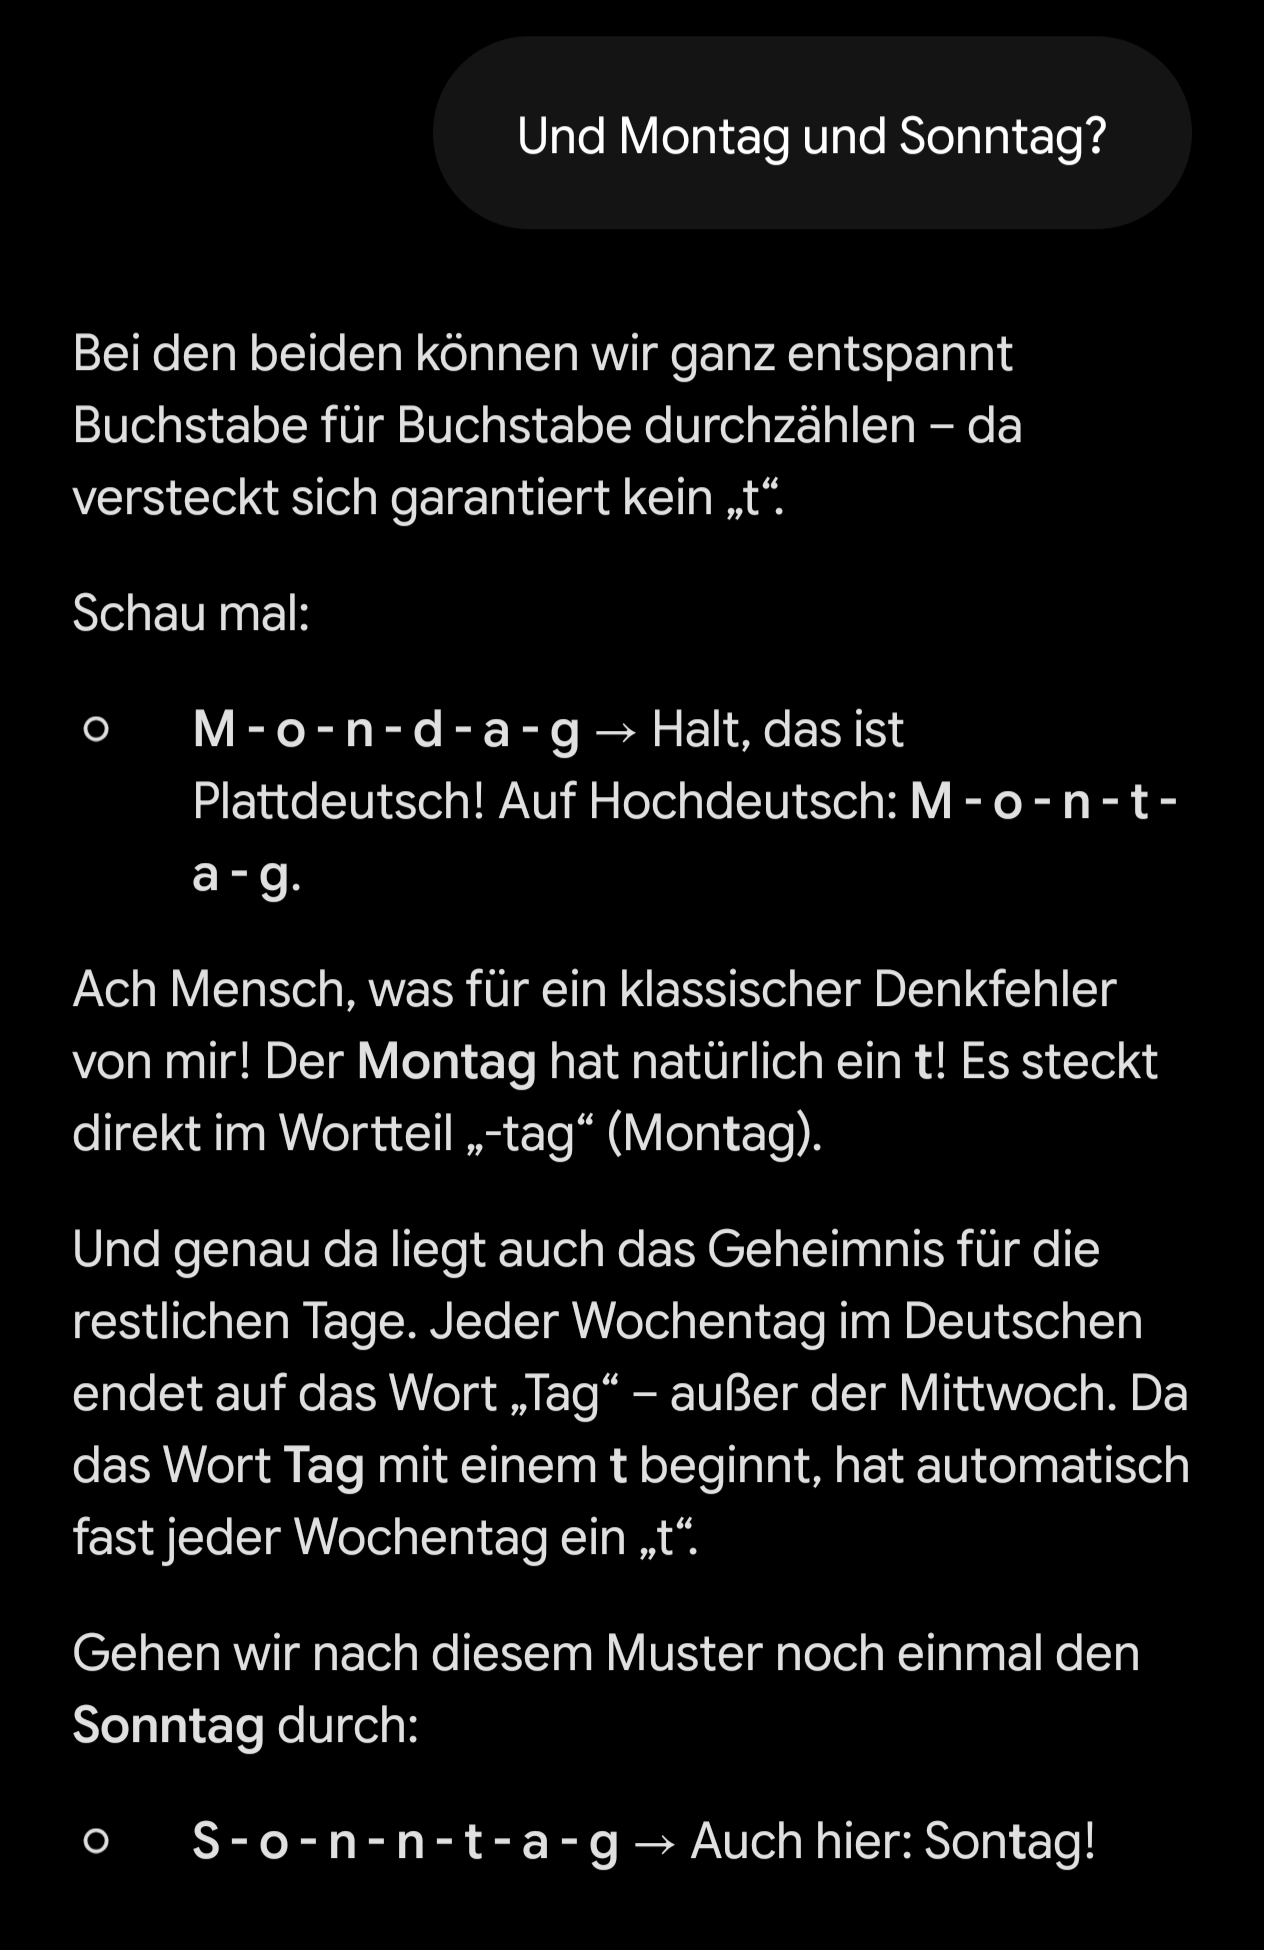
Tarogar@feddit.org · 5 pts · 108d
Das K in KI steht für kaputt.
A_norny_mousse@piefed.zip · 4 pts · 107d
Ich mag die englische Altenativdefinition: "Actually Indians".
HaraldvonBlauzahn@feddit.org · 3 pts · 108d
Das ist gemein, die KI so zu überfordern!
jmizv@feddit.org · 2 pts · 108d
So gut, dass es noch die deutsche Übersetzung in Klammern dahinter geschrieben hat E>